Computer Architecture: 프로세서·캐시 구성 성능 분석
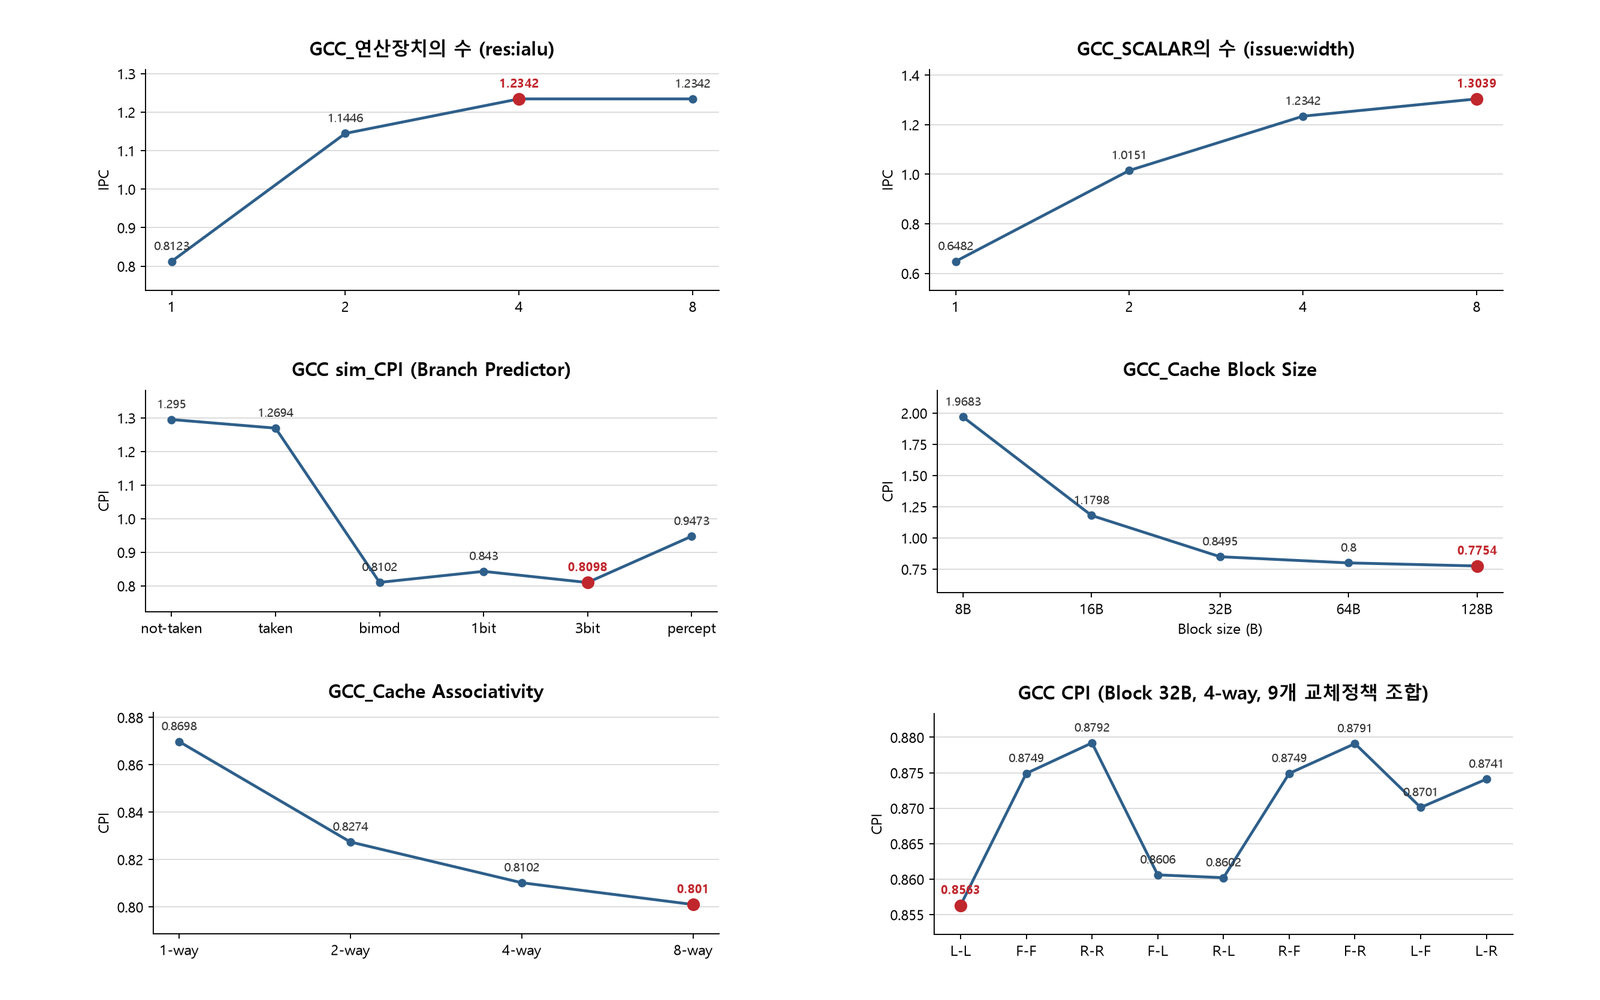
“연산 장치를 늘리면 항상 빨라진다”, “캐시를 늘리면 항상 좋아진다”는 가정이 실제로 어느 지점까지 맞고 어디서 깨지는지, 직접 시뮬레이션해서 확인해본 적은 없었습니다.
하드웨어를 직접 제작하지 않고도 이런 설계 옵션들의 효과를 비교할 방법이 필요했습니다.
SimpleScalar 시뮬레이터로 프로세서 구성(연산장치 수, superscalar width, branch predictor)과 캐시 구성(block size, associativity, replacement policy)을 바꿔가며 실험을 설계하고 수행했습니다.
GCC·ANAGRAM·COMPRESS95·GO 4개 벤치마크에 대해 시뮬레이션을 돌리고 결과를 분석했습니다.
res:ialu(정수 ALU 개수), issue:width(스칼라 수), bpred(분기 예측 방식)를 각각 바꿔가며 IPC/CPI 변화를 측정했습니다.
cache block size(8B~128B), associativity(1~8-way), replacement policy(LRU/FIFO/RANDOM 9가지 조합)를 바꿔가며 CPI·AMAT 변화를 측정했습니다.
개별 파라미터의 최적값을 먼저 찾은 뒤, 이를 조합했을 때 성능이 실제로 더 좋아지는지 검증하는 방식으로 최적 캐시 구성을 탐색했습니다.
연산 장치 수를 4개에서 8개로 늘려도 IPC가 그대로인 현상을 발견했습니다.
issue:width(한 사이클에 실행 단계로 넘길 수 있는 명령어 수)가 4로 고정되어 있어, 늘어난 연산 장치가 실제로는 활용되지 못하고 있었습니다.
캐시 쪽에서는 COMPRESS95와 GO에서 각각 측정 오류·워크로드 특성 문제를 발견해 재검증했습니다.
그 결과 애플리케이션마다 최적 조합이 다르다는 것을 확인했습니다 — 예를 들어 COMPRESS95는 다른 벤치마크와 달리 64B block size가 최적이었습니다.
4개 벤치마크 모두에서 개별 파라미터를 최적화한 조합이 각 파라미터를 단독으로 최적화했을 때보다 낮은 CPI를 기록해, 파라미터 간 상호작용을 수치로 입증했습니다.