Autoencoder 기반 이상 탐지 모델 하이퍼파라미터 최적화
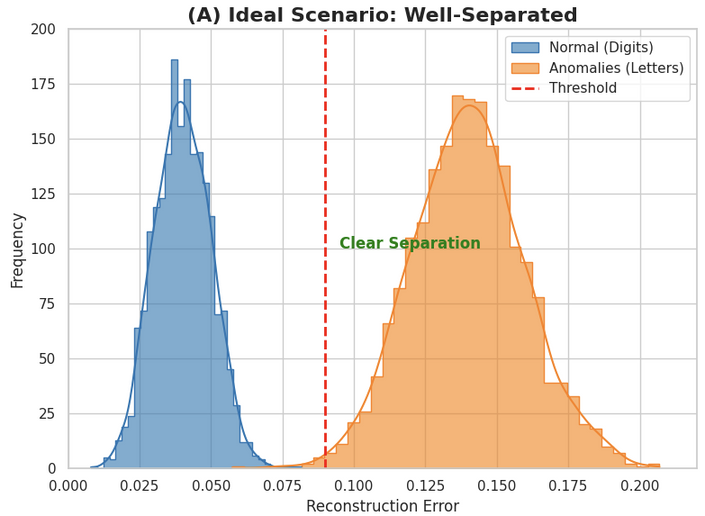
Baseline 모델(784-596-408-220-32 구조, GELU, Adam, lr 5e-3, epoch 400)을 그대로 돌렸더니 Validation 정확도는 94.5%인데 Test 정확도는 67.86%로 폭락하는 심각한 과적합이 나타났습니다.
epoch을 늘릴수록 모델이 이상 데이터까지 복원해버려서, 정상/이상을 가르는 threshold가 지나치게 낮아진 게 원인이었습니다.
Layer/Node 구조, Epoch, Batch Size·Learning Rate, Optimizer·Activation Function, Loss Function을 하나씩 바꿔가며 비교하는 하이퍼파라미터 최적화 실험을 진행하는 역할을 맡았습니다.
Layer/Node: 784-596-408-220-32에서 784-600-512-256-128-64-32로 층을 늘려 Latent Space 분리를 더 뚜렷하게 만들었습니다.
Epoch: 400에서 60으로 줄여 과적합을 억제했습니다.
Batch Size·Learning Rate: lr 0.001/0.005 × batch 64/128/256 조합을 전부 비교했습니다.
Optimizer·Activation: Adam+SiLU, AdamW+GELU, NAdam+ReLU 세 조합을 비교했습니다.
Loss Function: MSE, L1, HuberLoss, BCELoss를 비교했습니다.
가장 인상적이었던 건 Learning Rate 0.005에 batch 128을 같이 쓰니 Accuracy가 0.51까지 붕괴한 실험이었습니다.
학습률과 배치가 둘 다 크면 gradient 분산이 줄면서 최소점 주변을 지나쳐 진동·발산한다는 걸 수치로 확인했습니다.
반대로 lr 0.001은 batch 크기가 바뀌어도 안정적이었습니다.
최종적으로는 NAdam+ReLU 조합이 정상·이상 데이터의 재구성 오차 분리도가 가장 좋았고, Loss Function은 MSE가 가장 안정적으로 수렴했습니다.
최종 모델(784-600-512-256-128-64-32, ReLU, NAdam, lr 1e-3, batch 64, epoch 60, MSE)로 Test Accuracy 0.8116, Precision 0.8133, Recall 0.8090, F1-Score 0.8111을 달성했습니다.